Đừng mặc định chọn Medium: Cách tối ưu Effort Level trong Antigravity khi lập trình với Gemini
Khi sử dụng AI để lập trình, nhiều người có thói quen đặt mức độ suy luận (Effort Level) ở Medium và giữ nguyên thiết lập này cho mọi công việc. Đây có vẻ là lựa chọn an toàn vì nó nằm giữa Low và High.
Tuy nhiên, liệu Medium có thực sự là lựa chọn tối ưu? Một tác vụ đổi tên biến có cần cùng mức độ suy luận với việc thiết kế lại kiến trúc ứng dụng? Và việc tăng Effort Level có luôn giúp AI viết code tốt hơn?
Một thử nghiệm với Gemini 4 Argon và Gemini 3.8 Flash trong Antigravity cho thấy câu trả lời phức tạp hơn nhiều. Mức độ suy luận không chỉ ảnh hưởng đến chất lượng kết quả mà còn quyết định lượng thông tin AI tìm kiếm, số lệnh công cụ được thực thi, lượng token tiêu thụ và thời gian hoàn thành công việc.
Điều quan trọng là phải biết khi nào nên dùng Low, khi nào cần Medium và khi nào thực sự đáng để chuyển sang High.
1. Effort Level trong Antigravity thực sự có ý nghĩa gì?
Effort Level là thiết lập kiểm soát mức độ nỗ lực suy luận mà mô hình dành cho một tác vụ. Trong môi trường lập trình bằng AI, nó ảnh hưởng đến cách agent khám phá mã nguồn, thu thập thông tin, xem xét các phương án và kiểm tra hướng triển khai.
Có thể hình dung ba mức độ như sau:
- Low: Tập trung giải quyết công việc với phạm vi hẹp, hạn chế việc tìm hiểu thêm những thông tin không cần thiết.
- Medium: Dành thêm thời gian để hiểu bối cảnh, kiểm tra các tệp liên quan và cân nhắc cách triển khai.
- High: Cho phép agent khám phá sâu hơn, xem xét nhiều khả năng và xác minh kỹ hơn đối với những vấn đề phức tạp hoặc chưa rõ ràng.
Điểm cần lưu ý là Effort Level không đơn giản là một thanh điều chỉnh chất lượng code. Mức cao hơn không đảm bảo chương trình sẽ ít lỗi hơn trong mọi trường hợp.
Khi được cấp thêm ngân sách suy luận, agent có thể tìm hiểu nhiều tệp hơn, chạy thêm lệnh kiểm tra và xem xét nhiều giả thuyết hơn. Điều này có ích khi vấn đề phức tạp, nhưng cũng có thể khiến AI mất thời gian vào những hướng điều tra không đóng góp đáng kể cho kết quả cuối cùng.
2. Thử nghiệm Gemini 4 Argon và Gemini 3.8 Flash
Trong bài thử nghiệm gốc, tác giả sử dụng Antigravity CLI để chạy các tác vụ trên thư viện JavaScript mã nguồn mở ZX của Google.
Hai mô hình được lựa chọn là Gemini 4 Argon và Gemini 3.8 Flash. Mỗi mô hình được thử nghiệm ở ba mức Low, Medium và High, với bốn nhóm công việc:
- Đọc và tìm hiểu mã nguồn mà không sửa đổi.
- Refactor một phần xử lý Boolean với yêu cầu rõ ràng.
- Triển khai tính năng linear backoff với phạm vi tương đối cụ thể.
- Triển khai tính năng dry run có độ phức tạp và mức độ mơ hồ cao hơn.
Tác giả ghi nhận mức tiêu thụ token, chi phí ước tính, thời gian thực thi và hành vi sử dụng công cụ của agent.
Một giới hạn quan trọng: các cấu hình trong thử nghiệm đều vượt qua bước kiểm tra kết quả của những tác vụ được chọn. Vì vậy, thử nghiệm này chủ yếu giúp so sánh hiệu quả sử dụng tài nguyên và hành vi của agent, chứ chưa chứng minh mức Effort Level nào tạo ra code tốt nhất trong mọi tình huống.
3. Tăng Effort Level có thể khiến AI tiêu tốn nhiều tài nguyên hơn
Kết quả thử nghiệm cho thấy khi chuyển từ Low lên Medium hoặc High, agent thường sử dụng nhiều token hơn cho quá trình suy luận và thu thập thông tin.
Điều này có thể xuất phát từ việc agent:
- Đọc thêm các tệp trong dự án.
- Chạy thêm lệnh để kiểm tra môi trường và cách sử dụng công cụ.
- Tìm hiểu lịch sử hoặc các thành phần liên quan.
- Cân nhắc thêm những phương án triển khai trước khi chỉnh sửa code.
Đối với những tác vụ đơn giản, các hoạt động bổ sung này có thể không mang lại lợi ích tương xứng với lượng tài nguyên đã sử dụng.
Ví dụ, nếu yêu cầu chỉ là sửa một điều kiện trong hàm kiểm tra đầu vào, agent có thể không cần phân tích toàn bộ kiến trúc ứng dụng. Nhưng nếu yêu cầu là điều tra một lỗi chỉ xuất hiện trong môi trường production, việc đọc nhiều tệp và kiểm tra luồng dữ liệu có thể hoàn toàn cần thiết.
Vấn đề không phải là hạn chế AI suy nghĩ càng nhiều càng tốt. Vấn đề là dành đúng mức độ suy luận cho độ khó thực tế của công việc.
4. Mô hình đắt hơn chưa chắc khiến mỗi tác vụ đắt hơn
Một kết quả đáng chú ý trong thử nghiệm là Gemini 4 Argon có giá token cao hơn Gemini 3.8 Flash, nhưng chi phí hoàn thành từng tác vụ trong các kịch bản được kiểm tra lại có thể tương đương.
Ở kịch bản có mức độ mơ hồ cao nhất, tác giả còn ghi nhận Gemini 4 Argon có chi phí ước tính chỉ bằng khoảng một nửa Gemini 3.8 Flash ở cả ba mức Effort Level.
Lý do là chi phí thực tế không chỉ phụ thuộc vào đơn giá của mô hình mà còn phụ thuộc vào tổng lượng token cần thiết để hoàn thành công việc.
Có thể hình dung bằng công thức:
Chi phí tác vụ ≈ Chi phí token đầu vào + Chi phí token đầu ra + Các khoản tính phí liên quan khác.
Một mô hình có giá token cao hơn vẫn có thể hoàn thành công việc với chi phí thấp hơn nếu nó cần ít token hoặc ít vòng tương tác hơn.
Tuy nhiên, đây là kết quả từ những kịch bản cụ thể, không phải bằng chứng rằng Gemini 4 Argon luôn rẻ hơn Gemini 3.8 Flash. Khi lựa chọn mô hình, cần đánh giá chi phí thực tế trên chính loại công việc mà mình thường thực hiện.
5. Tốc độ xử lý nhanh không đồng nghĩa với hoàn thành tác vụ nhanh nhất
Gemini 3.8 Flash được biết đến với khả năng xử lý token nhanh. Nhưng thông lượng token cao không đồng nghĩa toàn bộ tác vụ sẽ hoàn thành trong thời gian ngắn nhất.
Một agent có thể xử lý token rất nhanh nhưng vẫn mất nhiều thời gian nếu phải thực hiện nhiều vòng đọc tệp, suy luận, gọi công cụ và kiểm tra lại.
Trong thử nghiệm, Gemini 4 Argon hoàn thành phần lớn các tác vụ nhanh hơn Gemini 3.8 Flash, ngoại trừ một tác vụ refactor cụ thể.
Điều này cho thấy cần phân biệt hai khái niệm:
- Tốc độ sinh token: Mô hình tạo ra token nhanh đến mức nào.
- Thời gian hoàn thành tác vụ: Toàn bộ thời gian từ lúc bắt đầu đến khi có kết quả đáp ứng yêu cầu.
Khi sử dụng AI để lập trình, chỉ nhìn vào tốc độ sinh token hoặc nhãn Flash và Pro là chưa đủ. Số vòng gọi công cụ, lượng thông tin phải khám phá và khả năng tìm được hướng giải quyết phù hợp cũng ảnh hưởng lớn đến thời gian thực tế.
6. Cái bẫy Overthinking: Khi AI tìm hiểu quá nhiều
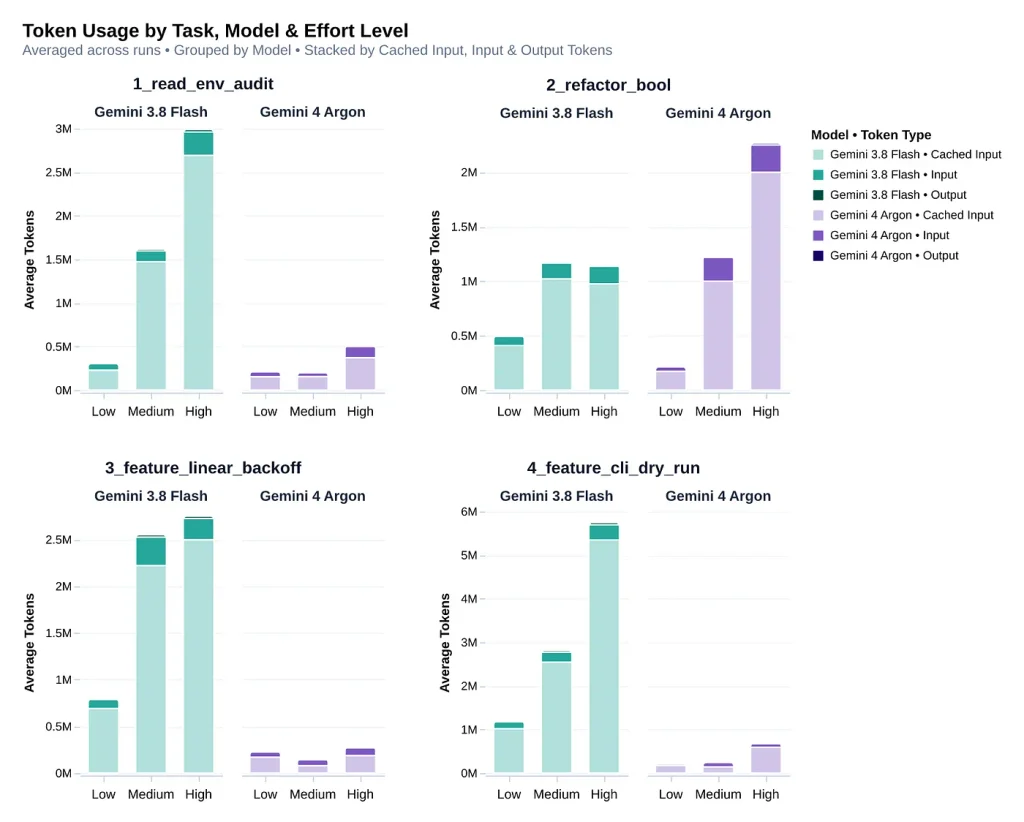
Một trong những quan sát đáng chú ý nhất của thử nghiệm là xu hướng tiêu thụ thêm token của Gemini 3.8 Flash ở mức Medium và High.
Tác giả nhận thấy các mức suy luận cao thường làm tăng số lần gọi công cụ, đặc biệt là những công cụ dùng để đọc tệp và chạy lệnh. Trong khi đó, số lần chỉnh sửa tệp cuối cùng tương đối giống nhau giữa các mức Effort Level.
Nói cách khác, agent có thể dành nhiều tài nguyên hơn để tìm hiểu môi trường nhưng không nhất thiết tạo ra nhiều thay đổi hơn trong code.
Đây là một dạng overthinking trong lập trình bằng AI.
Ví dụ, khi được yêu cầu sửa lỗi xác thực dữ liệu, agent có thể bắt đầu kiểm tra các module không liên quan trực tiếp, đọc lịch sử Git quá sâu hoặc cân nhắc việc tái cấu trúc toàn bộ hệ thống.
Những hoạt động đó đôi khi phát hiện ra vấn đề thực sự. Nhưng nếu không có dấu hiệu cho thấy chúng cần thiết, việc tiếp tục điều tra có thể làm tăng chi phí và kéo dài thời gian hoàn thành.
Để hạn chế tình trạng này, người phát triển nên:
- Xác định rõ phạm vi thay đổi.
- Cung cấp thông tin về các tệp và module liên quan khi đã biết.
- Yêu cầu agent ưu tiên những giả thuyết có căn cứ.
- Đặt tiêu chí hoàn thành và kiểm thử ngay từ đầu.
- Theo dõi các lệnh công cụ nếu agent bắt đầu đi quá xa khỏi mục tiêu.
Mức suy luận cao sẽ hữu ích hơn khi đi cùng một quy trình làm việc rõ ràng, thay vì chỉ tăng mức suy luận rồi để agent tự khám phá không giới hạn.
7. Khi nào nên dùng Low, Medium và High?
Không có một mức Effort Level phù hợp với mọi tác vụ. Cách tiếp cận thực tế hơn là lựa chọn dựa trên độ phức tạp, mức độ mơ hồ và hậu quả nếu triển khai sai.
Low: Công việc rõ ràng, phạm vi hẹp
Low phù hợp với những tác vụ mà yêu cầu và cách xác minh kết quả đã tương đối rõ ràng, chẳng hạn:
- Đổi tên biến, hàm hoặc thành phần.
- Sửa một lỗi nhỏ đã xác định được nguyên nhân.
- Refactor một đoạn code có phạm vi giới hạn.
- Đọc và tóm tắt cấu trúc một phần mã nguồn.
- Triển khai tính năng nhỏ đã có đặc tả và ví dụ kiểm thử.
Trong thử nghiệm gốc, tác giả báo cáo rằng Low có thể chạy nhanh hơn khoảng 3–5 lần và rẻ hơn khoảng 3–8 lần so với High trong các kịch bản được kiểm tra.
Đây là mức chênh lệch quan sát được trong thử nghiệm, không phải cam kết hiệu năng cho mọi dự án.
Nguyên tắc: Nếu công việc đã rõ, đừng buộc agent dành thêm ngân sách lớn để khám phá những khả năng không cần thiết.
Medium: Công việc có một phần chưa rõ ràng
Medium phù hợp khi agent cần hiểu thêm bối cảnh trước khi triển khai nhưng chưa cần điều tra quá sâu.
Ví dụ:
- Sửa lỗi liên quan đến một vài module.
- Bổ sung một tính năng nhỏ vào dự án hiện có.
- Tìm hiểu quy ước code và cấu trúc kiểm thử.
- Điều chỉnh luồng xử lý có một số trường hợp chưa được mô tả.
- Refactor khi chưa biết đầy đủ các thành phần chịu ảnh hưởng.
Medium là lựa chọn cân bằng khi chưa chắc mức độ phức tạp của công việc. Tuy nhiên, không nên mặc định rằng mọi tác vụ đều cần Medium chỉ vì đây là mức nằm giữa Low và High.
High: Công việc phức tạp hoặc có nhiều điểm chưa chắc chắn
High nên được dành cho những tác vụ cần phân tích sâu, đặc biệt khi quyết định sai có thể gây ảnh hưởng trên diện rộng.
Ví dụ:
- Thiết kế kiến trúc cho một tính năng lớn.
- Điều tra lỗi liên quan đến nhiều module.
- Phân tích vấn đề liên quan đến bảo mật hoặc dữ liệu.
- Xử lý lỗi khó tái hiện sau nhiều lần thử.
- Lập kế hoạch thay đổi cơ sở dữ liệu hoặc các thành phần phụ thuộc.
- Xem xét những phương án triển khai có nhiều đánh đổi.
High không thay thế cho đặc tả tốt, kiểm thử hay sự giám sát của người phát triển. Nó chỉ tạo điều kiện để agent dành thêm nguồn lực cho quá trình khám phá và xác minh.
8. Chiến lược Hybrid: Thay đổi Effort Level theo từng giai đoạn
Một cách sử dụng hiệu quả hơn là không giữ nguyên mô hình và mức suy luận trong toàn bộ vòng đời phát triển tính năng.
Có thể chia quy trình thành bốn giai đoạn.
Giai đoạn 1: Khám phá dự án
Sử dụng mô hình nhanh như Gemini 3.8 Flash với Low hoặc Medium để đọc các tệp, xác định cấu trúc và thu thập thông tin ban đầu.
Mục tiêu là xây dựng bức tranh tổng quan với chi phí hợp lý, không phải lập tức đưa ra mọi quyết định kiến trúc.
Giai đoạn 2: Phân tích và lập đặc tả
Khi yêu cầu còn mơ hồ hoặc liên quan đến nhiều thành phần, tăng Effort Level lên High nếu cần.
Agent có thể phân tích các phương án, xác định rủi ro, đề xuất kiến trúc, liệt kê các trường hợp biên và xây dựng kế hoạch triển khai.
Đây là giai đoạn nên đầu tư nhiều công sức suy luận vì những sai sót trong đặc tả có thể lan sang toàn bộ quá trình thực hiện.
Giai đoạn 3: Triển khai
Sau khi đặc tả đã rõ và công việc được chia thành những nhiệm vụ nhỏ, chuyển về Low hoặc Medium tùy độ khó.
Agent có thể tập trung viết code theo kế hoạch, thay vì tiếp tục khám phá lại những quyết định đã được thống nhất.
Giai đoạn 4: Kiểm tra và hoàn thiện
Sử dụng Medium cho các vòng kiểm tra thông thường. Chuyển lên High khi xuất hiện lỗi khó giải thích, kết quả kiểm thử không ổn định hoặc có nguy cơ ảnh hưởng đến nhiều thành phần.
Dù sử dụng mức nào, vẫn cần chạy kiểm thử và xem xét diff để xác nhận rằng thay đổi thực sự đáp ứng yêu cầu.
Chiến lược này giúp tập trung tài nguyên vào các quyết định khó, đồng thời giữ những công việc có phạm vi rõ ràng ở mức hiệu quả hơn.
9. Áp dụng vào quy trình vibe coding với Antigravity
Với quy trình vibe coding, người phát triển thường giao cho AI nhiều nhiệm vụ liên tiếp: đọc code, lập kế hoạch, triển khai, kiểm thử và sửa lỗi. Nếu tất cả các nhiệm vụ đều sử dụng cùng một mức suy luận, hệ thống có thể lãng phí tài nguyên ở những bước đơn giản hoặc chưa đầu tư đủ vào những bước quan trọng.
Một quy trình thực tế có thể áp dụng như sau:
| Giai đoạn | Effort Level gợi ý | Mục tiêu |
|---|---|---|
| Đọc hiểu dự án | Low–Medium | Nắm cấu trúc và quy ước hiện có |
| Phân tích yêu cầu | Medium–High | Làm rõ phạm vi, rủi ro và trường hợp biên |
| Thiết kế kiến trúc | High khi cần | Xác định giải pháp và ranh giới module |
| Lập kế hoạch | Medium–High | Chia nhỏ công việc, xác định tiêu chí hoàn thành |
| Viết code theo đặc tả | Low–Medium | Triển khai đúng phạm vi |
| Viết và chạy unit test | Low–Medium | Kiểm tra hành vi theo yêu cầu |
| Điều tra lỗi khó | High khi cần | Tìm nguyên nhân gốc và đánh giá các giả thuyết |
| Review và xác minh cuối | Medium–High | Kiểm tra diff, hồi quy và tác động liên quan |
Các mức trên chỉ là điểm khởi đầu. Tùy khả năng của mô hình, cách Antigravity cấu hình agent và đặc điểm dự án, bạn có thể cần điều chỉnh.
Đặc biệt, Effort Level không nên được dùng thay cho việc chia nhỏ nhiệm vụ. Một yêu cầu quá lớn và thiếu tiêu chí hoàn thành vẫn có thể khiến agent đi sai hướng, kể cả khi đặt High.
Cách tốt hơn là kết hợp ba yếu tố: đặc tả rõ ràng, nhiệm vụ có phạm vi giới hạn và mức suy luận phù hợp.
10. Kết luận: Đừng chọn Medium theo thói quen
Bài học quan trọng nhất từ thử nghiệm là Effort Level nên được xem như ngân sách dành cho việc khám phá và xác minh, thay vì một thanh trượt chất lượng.
Low phù hợp với công việc nhỏ, rõ ràng và dễ kiểm tra. Medium là lựa chọn cân bằng khi cần hiểu thêm bối cảnh. High nên dành cho những vấn đề phức tạp, mơ hồ hoặc đã thất bại khi giải quyết bằng mức thấp hơn.
Không nhất thiết phải sử dụng mô hình mạnh nhất ở mọi bước, cũng không cần giữ nguyên một mức suy luận cho cả dự án. Khi yêu cầu đã rõ, hãy giảm mức suy luận để triển khai nhanh hơn. Khi gặp vấn đề thực sự khó, hãy tăng mức suy luận và cung cấp thêm ngữ cảnh cần thiết.
Cuối cùng, mục tiêu không phải là khiến AI suy nghĩ nhiều nhất có thể. Mục tiêu là hoàn thành đúng công việc, với chất lượng có thể kiểm chứng và lượng tài nguyên hợp lý.
Bài viết tham khảo: Daniel Strebel, “Stop Defaulting to ‘Medium’: Optimizing Gemini 4 Argon and 3.8 Flash Effort Budgets in Antigravity”, Google Cloud trên Medium, ngày 15/10/2026.